
11 月 4 日,苹果研究团队在预印本平台 arXiv 提交了一篇论文,标题是《Perceptive Humanoid Motion from Simulation》,披露了一套叫人形机器人自己动起来的控制系统,名字叫 HALO。
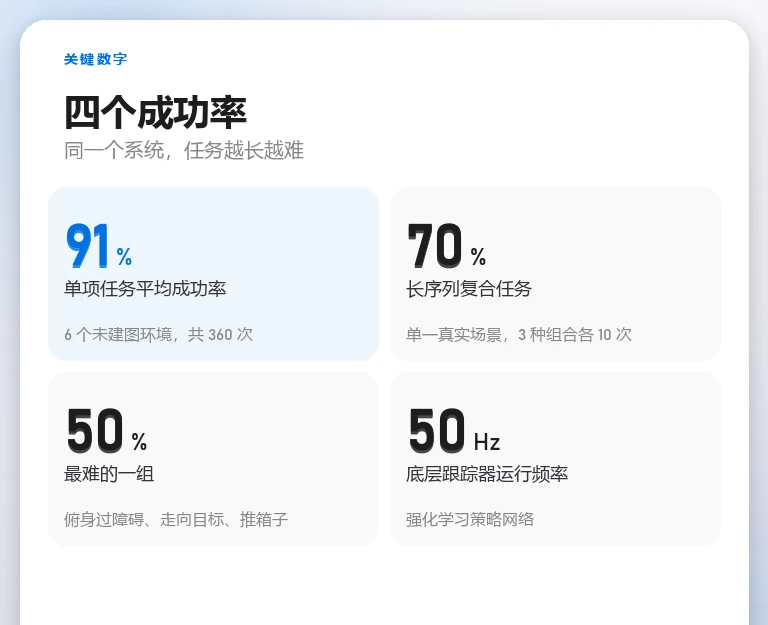
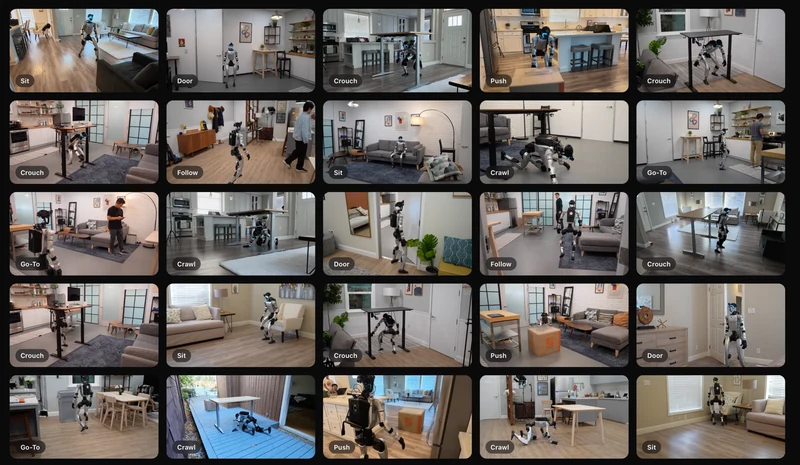
论文里最硬的一组数字是:在 6 个没有预先扫描、也没有建图的真实环境里,做了 360 次单项任务测试,平均成功率 91%。
机器人身上背了一台 Mac mini
落地测试用的不是苹果自己造的机器人,是宇树科技 G1。团队在它背部加装了一个专用 3D 打印保护外壳,外壳里装了一台 Mac mini,M4 Pro 芯片、64GB 统一内存。
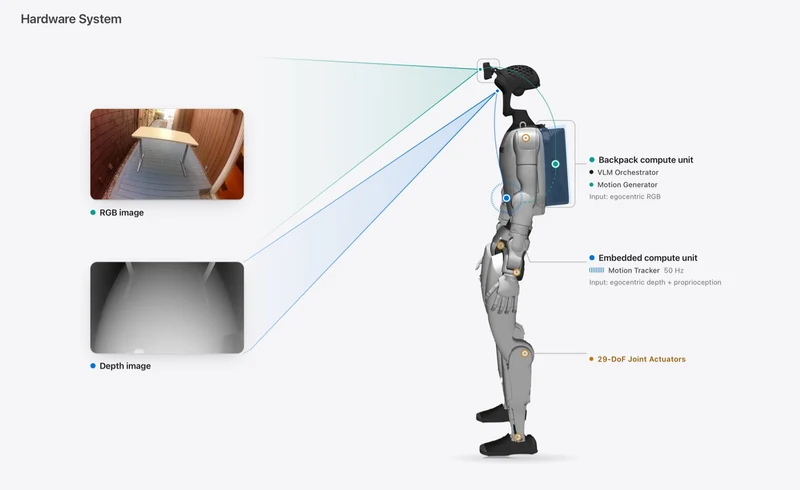
分工是这样的:Mac mini 负责在机载端实时推理计算开销大的部分,也就是任务编排的视觉语言模型和动作生成的扩散模型;G1 自带的板载芯片,则专门跑高频的动作跟踪网络。
用一台迷你主机当机器人的大脑,好处是算力够、散热好、开发时改代码方便。代价也直接——机器人得背着它走。
三层各管一段
HALO 的控制结构分三层。最上层是基于视觉语言模型的任务编排模块,默认用的是千问 Qwen3.6-35B-A3B,系统也可以改成通过 API 调用云端模型。
中间一层是动作生成,用的是另一个千问模型 Qwen3.5-2B。底层是经强化学习与策略蒸馏训练出来的动作跟踪器,以每秒 50 次的频率运行。
上层想清楚要干什么,中层把意图翻译成一段动作轨迹,底层以 20 毫秒一次的节奏把它落到关节上。三层里有两层跑的是阿里的开源模型,这一点在论文里写得很直白。
单项 91%,长序列掉到 70%
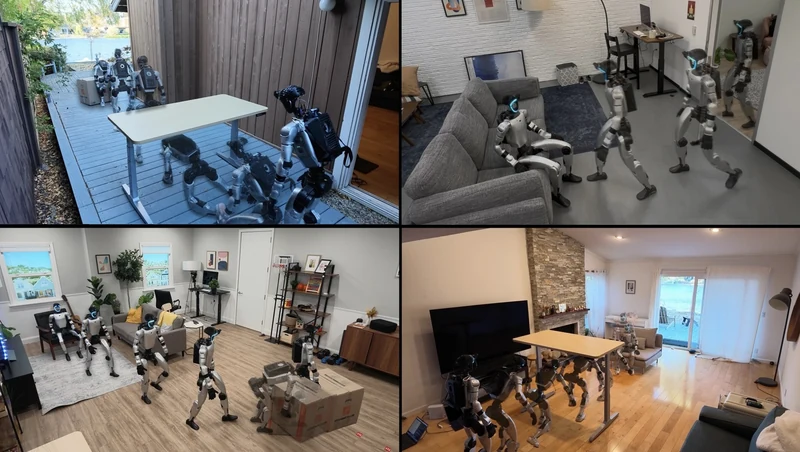
单项任务的成功率高,串起来就往下掉。团队在单一真实场景里各做 10 次长序列复合任务测试,3 种组合的平均成功率是 70%。
最难的一组是「俯身通过障碍 — 走向目标 — 推箱子」,10 次成功 5 次,50%。三个动作单拎出来都不算难,连在一起就有一半失败。
这个落差是这类系统的通病。每一步都有误差,误差会累积,到了第三步,起点已经偏了。
训练用了多少张卡
主要训练数据是合成出来的:250 张英伟达 H100,跑了大约 48 小时。动作生成器用模仿学习训练,用了 64 张 B200。动作跟踪器经强化学习与策略蒸馏,只用 4 张 H100。
张数差得这么多,是因为三层的训练方式完全不同:生成视频与动作轨迹的模型吃算力,跟踪一个已经定好的动作则是小模型的事。
仿真数据也不是白来的
团队自己写了这一条:新增物理任务仍然需要人工编写提示词、设计动作关键帧,部分动作还用了人类视频或者动捕素材。
也就是说,这套系统还没有做到「给个环境就自己学会」。每多一类新任务,前面仍要有人教它大概长什么样。
现在还做不到什么
论文里点得最明确的一条是触觉。机器人目前主要靠视觉感知,难以直接感知接触情况;物体离开相机视野或者被遮挡,涉及较多接触的任务表现就会下降。
这一条解释了长序列任务为什么掉得厉害——推箱子、钻桌底这类动作,物体的位置会一段时间离开视野,机器人在那几秒里只能靠猜。
团队把加入触觉感知列为后续改进方向之一。这也意味着现在这套 91%,是在没有触觉的前提下拿到的。
代码也一并放出来了
研究团队公开了数据生成、模型训练与部署的代码,涵盖动作生成、动作跟踪、任务编排,以及仿真环境和真机运行几个环节。
苹果很少把机器人研究的工程细节公开到这个程度。这次连训练管线和部署代码一起给,等于把复现的门槛降到了「有 G1、有 Mac mini、有显卡」这一档。
论文是预印本,还没有经过同行评审。里面所有数字都来自团队自己的测试,第三方还没有复现过。
声明:本文来自苹果迷投稿,不代表苹果家园立场,版权归原作者所有,欢迎分享本文,转载请保留出处!


你可能也喜欢
- ♥ 烂番茄满分的童话探案动画回来了:《The Sisters Grimm》第二季 10 月 2 日开播09/23
- ♥ Counterpoint 预测 iPhone Duo 年销量 600 万部:上市即抢占全球折叠屏两成半份额09/30
- ♥ watchOS 27 正式版推送:Series 9 起可升,初代 Ultra 与 Series 8 被砍09/15
- ♥ 苹果设备存储芯片或首次在美国生产:SK 海力士洽谈租用英特尔俄亥俄厂区,尚未最终确定09/17
- ♥ 传闻称Apple Watch将支持低轨卫星功能:可在危急时紧急救上一命04/14
- ♥ 武汉通上线 Apple Pay,万事达卡同日新增三家银行10/20