
按文件名搜文件是常识,DigUp 反过来——它按文件里有什么来搜:视频里斑马出现的那个瞬间、播客里提到睡眠的那一分钟、租约里宠物条款所在的那一页,都能直接跳到。这个 Swift 写的 Mac 工具跑在 Apple Silicon 上(macOS 14 及以上),底层是 Google DeepMind 十月发布的 EmbeddingGemma 2 多模态模型,740M 参数,全部在本机完成。
项目创建于 10 月 8 日,六天内在 GitHub 攒到 3277 个 star;最新的 v0.6.1 于 10 月 12 日发布,dmg 安装包 8,722,704 字节,MIT 许可。
它搜的是什么,又不是什么
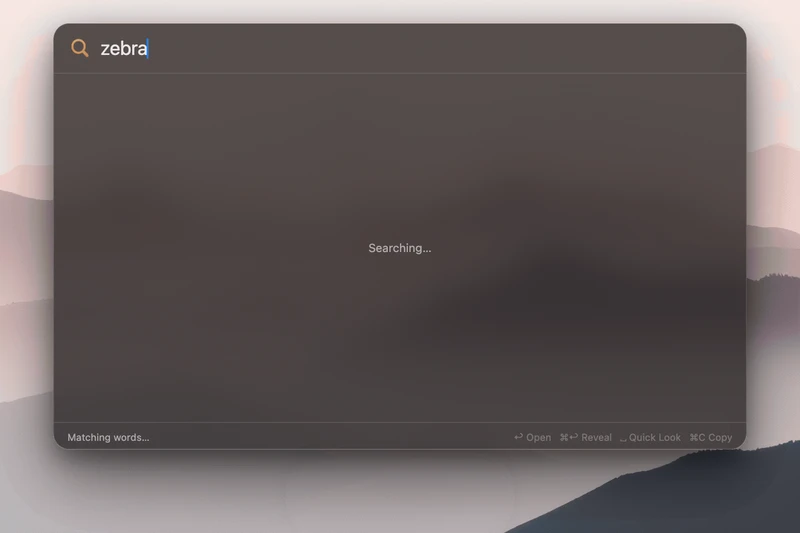
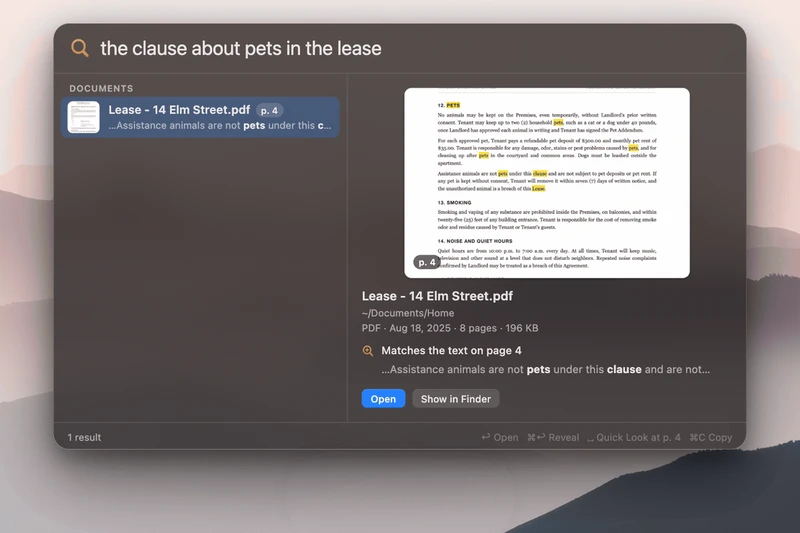
DigUp 读的是你选定文件夹里的文件内容,不是文件名。官方 README 列的使用场景:搜「zebra in a video」会直接打开斑马出现的那一格;搜「where they talk about sleep」跳到播客对应的分钟;搜「the clause about pets in the lease」给出 PDF 页码并把关键词在页面上标出来。
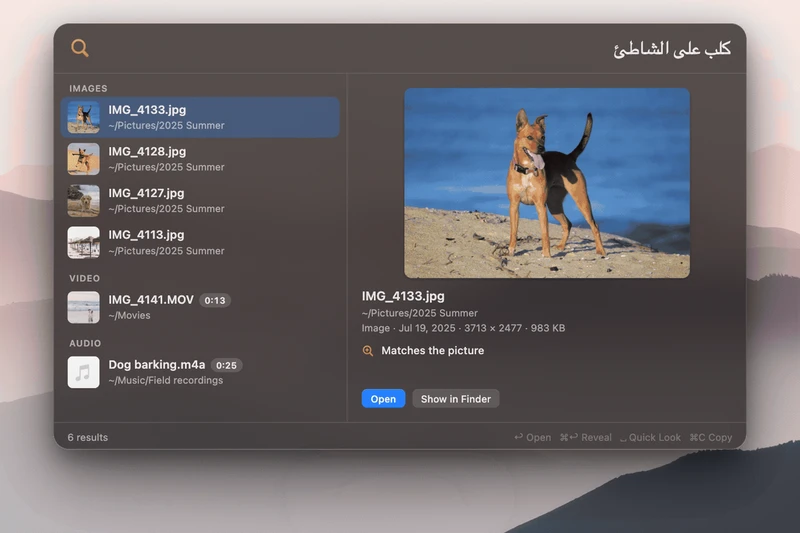
「a dog on the beach」能找到照片,「payment declined error」能找到截图里的报错文字。跨语言是这代模型自带的:一段英文查询可以找到孟加拉语或阿拉伯语写的笔记,反过来也一样,模型覆盖 100 多种语言。精确词同样保留——发票号、错误码、人名按原文匹配,文件名、正文和截图里的文字都算,所以一次搜索同时拿到「意思相近的」和「字面相同的」两类结果。
底下的模型:EmbeddingGemma 2
EmbeddingGemma 2 是 Google DeepMind 在 2026 年 10 月发布的多模态嵌入模型,Apache 2.0 许可。它把文本、图像、音频和视频放进同一个向量空间,所以一张海滩狗的照片会和「a dog on the beach」这几个词落在相邻位置——这也是为什么一个查询能同时给视频帧、PDF 页和录音片段排名。
DigUp 通过 llama.cpp 在 Mac 的 GPU(Metal)上跑这个模型的 8-bit 构建,每条内容对应一个 768 维向量,全部存在一个 SQLite 文件里,外加一份关键词索引。索引会记录生成向量所用的模型版本;模型更新若向量定义不变,旧索引直接沿用,每次 llama.cpp 升级都要先拿存档的参考向量做回归测试才发布。
搜索时模型只加载文本部分(约 250 MB),查询嵌入毫秒级完成,和索引里的向量做最近邻比较;精确词命中额外加权,因为嵌入表示装不下一个发票号。
安装与首次运行:865 MB 的大头是模型
安装本身两条路:到 Releases 页面下载 dmg 拖进 Applications,或者 Homebrew 一条命令。
brew install --cask arahim3/tap/digup第一次打开时才会开始下载模型,一共 865 MB——文本部分 310 MB,图像和音频编码器 555 MB,App 本身只有约 20 MB。下载完选要搜的文件夹,可以整盘也可以只选子文件夹,DigUp 会按文件夹估算首遍索引要多久。之后在任何 App 里按 ⇧⌘Space 就能唤出搜索面板。
首遍索引几百个文件是几分钟,一个很大的 Downloads 文件夹可能要到一小时,电池供电时也跑(可以改成等接电源),低电量模式下自动暂停。这之后新落地的文件一两秒就能搜到。
隐私边界写得很细
这类要读你整个硬盘的工具,隐私条款值得逐条看,DigUp 在这件事上写得比较明确。
只读你选定的文件夹。没选的目录一概不碰,选了代码搜索的文件夹之外也从不读代码;在代码项目内部(有 .git、package.json 这类标志的文件夹)只读截图。
有一份明确的跳过清单。密钥、证书、密码文件、~/.ssh 这样的隐藏文件夹、App bundle 和缓存目录都不读;看起来像数据集的文件夹跳过;只存在于 iCloud 云端的文件不下载。它只读文件,从不修改、移动或上传。
联网只有两次。首次下载模型,以及每天一次的更新检查——后者可以关掉,且不发送任何与文件有关的信息。没有账户,没有遥测。
代码搜索默认关着
代码搜索要在 设置 → Code 里手动打开,每个参与搜索的仓库会分别显示建索引所需的时间和空间。
打开之后,搜索以 code: 开头:code: retry a failed call with backoff 能找到对应函数而不在乎它叫什么,code: refreshAccessToken 直达定义所在行而不是调用点。结果在你选的编辑器里打开那一行——Zed、VS Code、Cursor、Xcode、Sublime Text、JetBrains 系列都支持。
代码索引独立存放,不出现在其他搜索结果里。它读源文件、笔记本(不含输出)和仓库自带文档,跳过 git 忽略的、第三方的、生成的代码、数据文件以及任何疑似密钥或密码的内容。读 llama.cpp 全量代码约需 20 分钟、130 MB 索引,一个小 App 大约 20 秒。
几条已知的边界
Windows 和 Linux 版还没有。README 对两者的说法都是「on the way」,当前只有 Mac 版。
中文等无空格语言不做分词。意思层面的搜索不受影响,但精确词匹配依赖分词,中文、日文、泰文这类不按空格断词的语言会吃亏;截图内文字由 Apple 的文字识别读取,覆盖约 25 种语言。v0.6.1 已修复韩文、日文和中文在搜索框的输入问题。
它是第一周的版本。首个公开版本 v0.6.0 发布于 10 月 9 日,v0.6.1 的更新说明写的是「修复第一周里大家遇到的问题」:扫描版 PDF 的文字识别、SVG 图片支持、索引期间文件夹变动、可设定时索引时段、可从别处加载已下载的模型。60 个 open issue 也说明它还在早期。更新通过 Sparkle 完成,安装包带 EdDSA 签名。
卸载时删除 DigUp.app 和 ~/Library/Application Support/DigUp(模型和索引都在这里),设置项在 com.abdurrahim.DigUp.plist;Homebrew 用户可以用 brew uninstall --cask --zap digup 一次清干净。
它和 Spotlight 不冲突:Spotlight 按名称、文本和元数据找,DigUp 按画面和声音的内容找并直达页面或时刻,两个可以并存。
官方入口
项目仓库:github.com/ARahim3/DigUp。安装到 Releases 页面下载 dmg,或 brew install --cask arahim3/tap/digup。
门槛是 Apple Silicon 与 macOS 14 及以上,作者称在 macOS 26 上测试。许可为 MIT,模型为 Apache 2.0,llama.cpp 与 Sparkle 为 MIT,致谢随 App 发布。
声明:本文来自苹果迷投稿,不代表苹果家园立场,版权归原作者所有,欢迎分享本文,转载请保留出处!


你可能也喜欢
- ♥ iPhone 18 Pro 三周激活破 300 万:砍单与销量反着走,Pro Max 单周超 76 万10/10
- ♥ macOS 27 强制下载 AI 模型:官方标称最高 14GB,实测有 Mac 被吃掉 30GB09/23
- ♥ iPhone Duo 分屏多工却放不了双视频:iOS 音轨独占机制挡住的双屏观影场景09/11
- ♥ Apple Watch Series 12 上手:传感器换了、充电更快,和 Ultra 4 差在续航与体积09/19
- ♥ macOS 27 给自带 App 补了一批 Apple Intelligence:照片能往外扩图,Safari 一句话造扩展09/26
- ♥ Android安卓全球市占率持续衰退:苹果iOS稳定增长04/24