
Xserve 在 2011 年停产之后,苹果再没卖过一台机架服务器。替它接下这份活的是摆在桌上的 Mac Studio:苹果机器学习研究站那篇分布式推理的记录里,四台 M5 Ultra 机器连起来跑 Meta 开源的 Muse Spark Open,输出超过每秒 36 个 token,单机峰值功耗约 300 瓦。
9to5Mac 的 Apple @ Work 专栏在 11 月 14 日把这套组合称为 Xserve 的精神继任者。作者 Bradley Chambers 从 2009 年起做苹果 IT 管理,他给出的判断是苹果没有去争前沿模型,而是把跑模型需要的内存、带宽和框架做完了。
两台机器装下 8160 亿参数
Meta 在 10 月放出 Muse Spark Open,同时把它优化成能在 Mac Studio 上运行。这个模型总参数 8160 亿,每次推理激活其中 420 亿,上下文窗口 100 万 token,权重公开,可以自己下载。
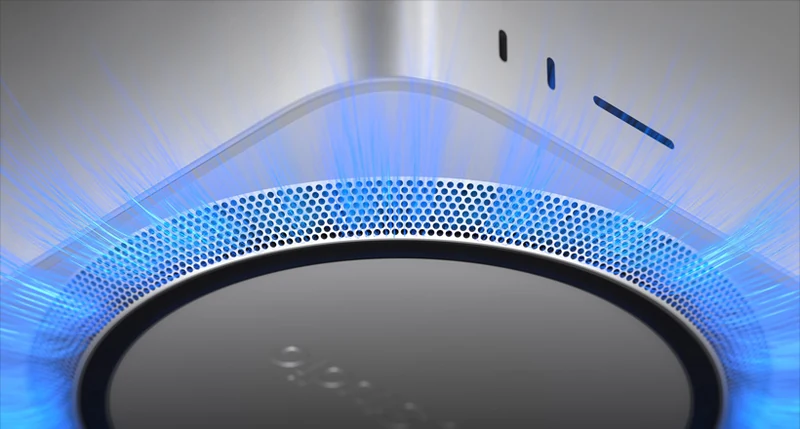
Meta 对硬件的描述写得很具体:统一内存让 M5 Ultra 的集成 GPU 单机用到 512 GB,两台机器就装得下整个模型;内存带宽 1.2 TB/s,够快,能读完每个 token 需要的那一小片。两台 Mac Studio 合起来,表现得像一台有一 TB 统一内存的超级计算机。
模型没有为桌面做裁剪,是桌面机器的内存池足够大,装得下一个原本要一整柜 GPU 的模型。
四台连起来时做的是分布式推理:模型被分放到几台机器上,彼此通过网络交换中间结果,每台的 GPU 只算自己那一段。
苹果出的是内存、带宽和 MLX
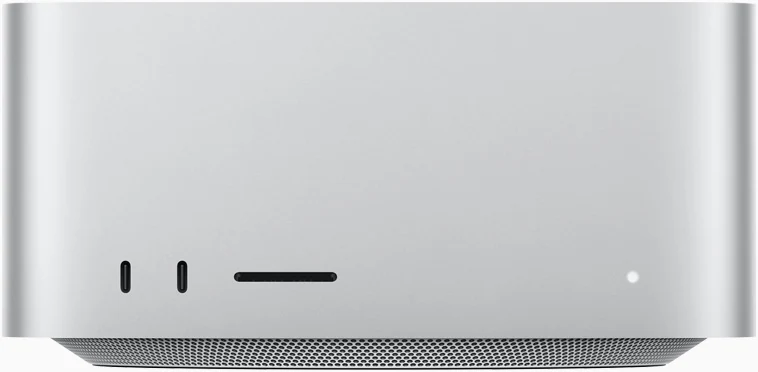
独立显卡的显存封顶在几十 GB,一张卡装不下的模型就得切成多份,靠卡间互联来回搬。统一内存走的是另一套:CPU 和 GPU 共用同一个内存池,M5 Ultra 的 GPU 能直接用到 512 GB,搬运这一步被省掉了。
MLX 是苹果自己的机器学习框架,按统一内存的结构设计。它的接口和 NumPy 接近,上层带神经网络与优化器的高阶包,还有自动微分和图优化,Swift、C++、C 都有绑定,任何苹果平台都能跑。
框架开源、内存共享、带宽够宽,三样凑齐之后,模型从哪来就不重要了。苹果不必自己训一个 8160 亿参数的模型,它只要保证别人训出来的模型能在自己的机器上跑起来。
同一套思路在 Claris 那边有过另一个版本:几台 Mac 用雷雳线拼成一台 AI 服务器,走的是把机器直接连起来的做法。
每秒 36 个 token 与 300 瓦
苹果记录里的数字是四台 M5 Ultra 跑出超过每秒 36 个 token,这个速度比人阅读还快。四台按峰值算,总功耗约 1.2 千瓦。
1.2 千瓦是什么量级:一台家用电暖器就是这个数,普通办公室的一路插座带得住。专栏里那句「安静到可以放在桌子底下」,说的正是这一点。
Xserve 的时代,同样的算力要进机柜,要机房空调,要有人管电和网。现在这套东西散在一张桌子上,插普通电源就能开机。
代价也在这里:桌面上没有冗余电源,没有带外管理,没有机房那套监控。把它当服务器用,运维的活得自己补。
Meta 拿这套机器做了什么
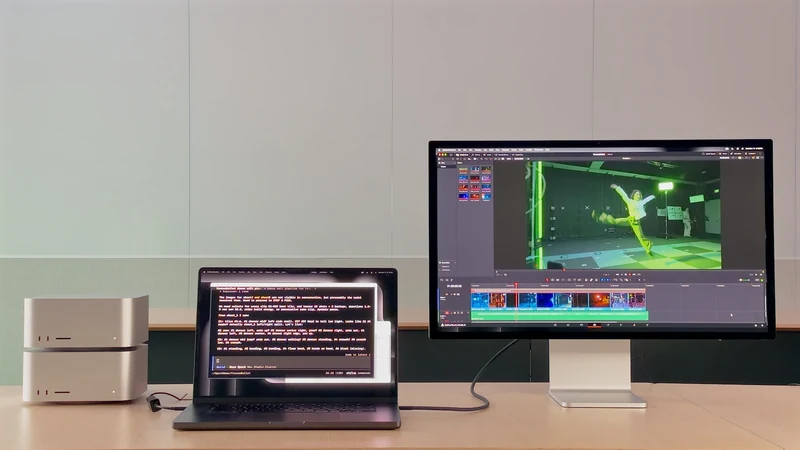
Meta 公布的两段测试都在设备本地完成,没有走云。第一段是用 Muse Code 驱动 Muse Spark Open 改一个开源 iOS 客户端 Ice Cubes,修 bug、加功能、跑完整构建,最后提交的是真实的代码改动。
第二段是驱动 DaVinci Resolve:模型逐帧看素材,挑出最有力量的镜头,再裁成竖屏。这类活过去要上传到云端排队,现在在一块屏幕前跑完。
两段测试指向同一件事:能跑模型和能干活之间,差的是 agent 这一层。模型输出 token,agent 把 token 变成文件改动和剪辑操作。
统一内存在这套流程里的位置也就清楚了。agent 干活时上下文一直在涨,模型、缓存、素材得同时待在内存里,显存一满就得停下来搬数据。
16 GB 的 MacBook 也能跑
桌面那套是上限,多数 IT 团队真正会碰的是下限。专栏里提到的 Osaurus 是一个免费开源的 Mac 工具,它管本地模型,断网也能跑,需要时也能转去调前沿模型。
它有一个动作值得单独看:调用云端之前,先跑一个小模型把粘贴内容里的人名、电话、账号找出来,替换成占位符,再把剩下的发出去。
Osaurus 没有服务器,也没有客户数据库。按作者的说法,公司明天倒闭,这个 App 也能一直跑到 macOS 不再兼容它为止。
它有两个模型能在 8 GB 内存的机器上跑,16 GB 的笔记本属于宽裕的一档。个人免费,团队要共享 agent 得买 Workspaces 那一层,Windows 测试版已经有了。联合创始人 Terence Pae 在播客里说,明年这个时候本地模型可能追平今天的前沿模型。
苹果没参加的那场比赛
过去几年主流说法是苹果在 AI 上落后,因为没有前沿模型,Siri 的更新也一再推迟。专栏承认这一点:Siri 到现在仍然落后。
前沿模型这门生意本身在变成一场烧钱的竞赛。每家实验室都在花数十亿美元买 GPU,只为在几个月里做到最好;而模型一旦够好,很快有人放出开源权重版,跑在已经买回来的硬件上。
苹果建的是除前沿模型之外的全部:内存、带宽、框架、能效。这套做法不保证苹果赢下模型那一局,但保证别人赢下的模型能跑在它的机器上。
MacStadium 这类做 Mac 托管的服务商是直接受益方,企业不必自己买机器,租几台放进机房就能跑同一套东西。
现在该不该把机房换成一排桌子
如果团队只是不想让文档、代码和客户资料出内网,一台 16 GB 的 Apple silicon 机器就够起步。先装 MLX 或 Osaurus 跑一次离线推理,量一下自己的任务要几秒,再谈采购;把「两台 Mac Studio 顶一台超算」当成买机器的理由,多半会失望。
真要跑满 8160 亿参数、还要几个人同时用,得看清 36 个 token 是四台机器的总量。一台机器一条流水线,两个人同时提问就得分摊,这个吞吐撑不住并发。
Xserve 当年退出,原因不是性能,是没人愿意为一台机架式 Mac 单独准备机房和维保。这次苹果卖的是桌面机器,机房那套东西得买家自己想办法。愿不愿意换,取决于你是想省电费,还是想省运维。
声明:本文来自苹果迷投稿,不代表苹果家园立场,版权归原作者所有,欢迎分享本文,转载请保留出处!


